「心理学の研究は、100本のうち36本しか再現されなかった」。
この数字を聞いて、心理学そのものを信じられなくなった人もいるかもしれません。あるいは、逆に「やっぱり心理学はあてにならない」と、もともとの疑いを確かめた気になった人もいるかもしれません。
どちらも、少し急ぎすぎです。
2015年に発表された大規模な追試研究は、確かに衝撃的な結果を出しました。ただ、その研究が測ったのは「心理学全体」ではありません。2008年に3つの主要な学術誌に載った100本の研究を、もう一度やり直したらどうなるか、でした。
この記事では、その100本の追試で何が起きたのかを、数字の読み方から整理します。なぜ再現しなかったのか、反論は何だったのか、2015年のあと何が変わったのか。そして最後に、読む側が1本の研究をどう扱えばいいのか、具体的な見方を提示します。
この記事でわかること
- 100本の追試で何が起きたのか。36%・39%・47%・68%という4つの数字の意味
- 再現性と反復可能性の違い、p値・効果量・検出力・事前登録の意味
- 再現されなかった4つの理由と、反論の内容
- 2015年以降、心理学の研究文化がどう変わったのか
- 1本の研究の強さを測る「5つのレンズ」と、ニュース見出しの診断ワーク
先に結論
心理学研究の再現性は、「36%」という一つの数字では語れません。
同じ追試研究の結果を、測り方を変えて見ると、こうなります。
- 有意な結果が同じ方向で再現された割合:36% [1]
- 追試チームが主観的に「再現した」と判断した割合:39% [1]
- 原研究の効果量が、追試の95%信頼区間に入っていた割合:47% [1]
- 原研究と追試を合わせて分析したときに、有意な結果が残った割合:68% [1]
どれも同じ100本の追試から出た数字です。測り方によって、36%から68%まで変わります。
もう一つ、効果の大きさも重要です。追試での効果量の平均は、原研究のおよそ半分でした。相関係数で表すと、原研究の平均 r = 0.403 に対して、追試は r = 0.197 でした [1]。つまり、「再現されたかどうか」だけでなく、「再現されたとしても、効果は思ったより小さい」ことが多かったのです。
ここから言えるのは、次のことです。
心理学の知見は、1本の論文だけで「証明された」とは言えません。ただ、だからといって心理学のすべてが崩れたわけでもありません。再現性の危機が示したのは、研究の読み方そのものを変える必要がある、ということです。
用語集――この記事で使う言葉
この記事では、いくつかの専門用語を使います。ここで一度、意味をそろえておきます。
| 用語 | 意味 | この記事での使い方 |
|---|---|---|
| 再現性(reproducibility) | 同じデータと、同じ分析方法を使って、同じ結果が得られるか | データと分析のやり直し |
| 反復可能性(replicability) | 別の研究チームが、新しいデータを集めて、同じ方法で試したときに、同じ知見が確認できるか | OSC 2015が検証したのはこちら |
| p値 | 効果がないと仮定したときに、そのデータ以上に極端な結果が出る確率 | 「有意(p < .05)」の基準になる数値 |
| 効果量 | 効果の大きさ。p値とは別に、「どれくらい効いたか」を表す | r や Cohen’s d などで表す |
| 検出力 | 効果が本当にあるときに、それを正しく検出できる確率 | 参加者が少ないと低くなる |
| p-hacking | 有意な結果が出るまで、分析の仕方を変え続けること | 詳しくは後述 |
| HARKing | 結果を見たあとで、仮説をあと付けで作ること | Hypothesizing After the Results are Known |
| 出版バイアス | 有意な結果だけが発表されやすく、有意でない結果が発表されにくい偏り | ファイルドロワー問題ともいう |
| 事前登録 | データを集める前に、仮説と分析計画を公開の場に記録しておく仕組み | p-hackingやHARKingへの対策 |
| メタ分析 | 複数の研究の結果を統合して、全体の効果を推定する方法 | 1本の研究より強い証拠になる |
p値と効果量の違いは、とくに大切です。p値は「効果があるかどうか」の目安で、効果量は「効果がどれくらい大きいか」の目安です。p値が小さくても、効果量が小さければ、実生活での意味は限られます。逆に、効果量が大きくても、参加者が少なければ、p値は有意にならないことがあります。どちらか一方だけを見るのではなく、両方を見ることが、研究を読むときの基本です。
再現性と反復可能性の違い
まず、言葉の整理から始めます。日本語ではどちらも「再現性」と訳されがちですが、英語では区別があります。
- 再現性(reproducibility):同じデータと、同じ分析方法を使って、同じ結果が得られるか。
- 反復可能性(replicability):別の研究チームが、新しいデータを集めて、同じ方法で試したときに、同じ知見が確認できるか。
2015年の追試研究が検証したのは、後者の反復可能性でした [1]。別のチームが、新しい参加者を集めて、原研究と同じ手順で実験をやり直したのです。
この区別は、数字を読むうえで大切です。追試で有意な結果が出なかったからといって、原研究が「嘘だった」と決まるわけではありません。偶然のばらつき、参加者の違い、手順の細かな違いでも、結果は変わり得ます。逆に、追試で有意な結果が出たからといって、その知見があらゆる条件で成り立つとも限りません。
再現性の危機を考えるときは、「再現されたか、されなかったか」の二択ではなく、「どのくらい強く、どの条件で、どれだけ繰り返し確認されたか」を見る必要があります。
100本の追試は何をしたのか
追試研究の正式な名前は、Reproducibility Project: Psychology です。Open Science Collaborationという、約270人の研究者の集まりが進めました [1]。
対象になったのは、2008年に3つの主要な心理学の学術誌に掲載された研究です。
- Psychological Science
- Journal of Personality and Social Psychology
- Journal of Experimental Psychology: Learning, Memory, and Cognition
この3誌から、実験研究と相関研究を合わせて100本を選び、原研究の材料が手に入る場合はそれを使い、検出力の高い設計で追試を行いました [1]。
ここでいう「検出力の高い設計」とは、原研究の効果が本当にあれば、それを見逃しにくいだけの参加者数を確保する、という意味です。追試のサンプルサイズは、原研究のおよそ5倍でした。
追試の結果をどう評価するかには、一つの標準はありません。そこで研究チームは、5つの指標を併用しました。
- 有意性とp値
- 効果量
- 追試チームによる主観的な評価
- メタ分析
- 原研究と追試を合わせた分析
この「一つの数字では決めない」という姿勢自体が、この研究の重要な点です。あとで見るように、指標によって結論の見え方は変わります。
年表――再現性の危機は、2015年に突然起きたわけではない
再現性の危機は、2015年に突然現れたものではありません。2005年から2018年までの流れを、年表で見ます。
| 年 | 出来事 |
|---|---|
| 2005年 | Ioannidisが「発表された研究結果の多くが誤っている可能性」を指摘 [6] |
| 2011年 | Simmonsらが「False-Positive Psychology」を発表。p-hackingの仕組みを示す [3] |
| 2012年 | Registered Reportsの形式が提案される |
| 2015年 | Open Science Collaborationが100本の追試結果を発表 [1]。Nosekらがオープンな研究文化の提言を発表 [9] |
| 2016年 | GilbertらがOSCへの反論を発表 [4]。OSCが応答 [5]。Natureが1,576人の研究者への調査を発表 [7] |
| 2018年 | Many Labs 2が28の研究の追試結果を発表 [2] |
この年表から分かるのは、再現性の危機は「ある日突然、心理学が壊れた」という話ではない、ということです。問題の指摘は2005年からあり、2011年にp-hackingの仕組みが示され、2015年に大規模な追試で数字が出て、2016年に反論と応答があり、2018年に別の大規模な追試で結果が積み重なった。そうした積み重ねの話です。
数字の読み方――36%、39%、47%、68%
ここで、冒頭の4つの数字をもう一度、丁寧に見ます。
- 36%:追試で、原研究と同じ方向に有意な結果(p < .05)が得られた割合。原研究では97%が有意でした [1]。
- 39%:追試チームが「再現した」と主観的に判断した割合 [1]。
- 47%:原研究の効果量が、追試の効果量の95%信頼区間に入っていた割合 [1]。
- 68%:原研究と追試の結果を合わせたときに、有意な結果が残った割合。ただし、これは「原研究の結果にバイアスがないと仮定した場合」の数字です [1]。
36%だけを取り出して「心理学の3分の2は嘘だった」と読むのは、早計です。なぜなら、追試で有意にならなかった研究の中にも、効果がゼロだった研究と、効果はあるが小さくて有意水準に届かなかった研究が混ざっているからです。
逆に、68%だけを取り出して「ほとんど再現された」と読むのも、同じくらい早計です。68%は、原研究の結果に出版バイアスなどのゆがみがないと仮定したときの数字で、その仮定自体がこの問題の中心だからです。
この記事の立場は、こうです。
「36%」は、心理学全体の再現率ではありません。100本という特定のサンプルで、特定の基準(p < .05で、同じ方向に有意)を使ったときの推定値です。
それでも、この数字が重いのは確かです。原研究の97%が有意だったのに、追試では36%しか有意にならなかった。効果量も平均で半分になった。この落差は、「有意な論文だけが載りやすい」という仕組みと、「効果量が過大に報告されやすい」という仕組みが、組み合わさって起きたものと考えられます。
なぜ36%だけが広まったのか
4つの数字があるのに、なぜ「36%」だけが広まったのでしょうか。一つには、分かりやすさがあります。「100本のうち36本しか再現されなかった」は、見出しにしやすい数字です。「39%」「47%」「68%」を並べると、話が複雑になります。
もう一つには、驚きがあります。「心理学はほとんど再現されない」という話は、人の注意を引きます。「測り方によって36%から68%まで変わる」という話は、正確ですが、見出しにはなりにくい。
ここに、研究の読み方と、ニュースの読み方の違いがあります。ニュースの見出しは、数字を一つに絞ります。研究の読み方は、数字を複数並べて、測り方の違いを見ます。この記事では、あえて4つの数字を並べました。面倒ですが、それが正確な読み方だからです。
SNSで「極端な意見ばかり目立つ」仕組みと、少し似ています。画面に並ぶのは、すべてを数えた結果ではなく、いくつもの選択を通った結果です。研究の数字も同じで、どの数字が見出しになるかには、選択が働いています。
SNSで極端な意見が目立つ仕組みを、投稿する人・拡散・表示の選択から整理した記事です。→ https://kitarekoi.com/social-media-extreme-opinions/
指標別の再現率
以下の図は、同じ100本の追試を、4つの指標で見たときの結果です。測り方によって、36%から68%まで変わります。
分野で違う再現率
100本の追試は、分野によって結果が大きく違いました。
- 認知心理学:約50%が再現された
- 社会心理学:約25%が再現された
この分野差は、統計的にも有意な違いでした [1]。対象になった100本のうち、57本が社会心理学、43本が認知心理学でした。
なぜ分野で差が出たのか。論文自体は「分野によって研究の慣行が違うためではないか」と述べています [1]。たとえば、社会心理学では、状況や文脈に依存する効果が多く、参加者の属性や実施環境の違いが結果に影響しやすい、という指摘があります。認知心理学では、実験条件を統制しやすい課題が多い、という違いもあります。
ただし、ここでも注意が必要です。「社会心理学は信用できない、認知心理学は信用できる」という二分法は、研究が示したことではありません。分野の中でも、研究ごとに再現性は大きく違います。分野差は、どこに注意して読むべきかの目安であって、個別の研究の評価を代わりにするものではありません。
この分野差は、NOCTOGRAPHの記事を読むときにも関係します。たとえば、恋愛や対人関係の話題では、社会心理学の知見がよく使われます。そうした記事を読むときは、「1本の実験だけで結論を出していないか」「追試やメタ分析はあるか」を、とくに確かめたいところです。
ダニング=クルーガー効果の原研究と、その後の統計的な反論を比較した記事も、1本の有名な研究をどう読むかの参考になります。→ https://kitarekoi.com/dunning-kruger-confidence-self-assessment/
1本の行動から、その人の性格を決めない
分野差の話は、人の判断の話ともつながります。1回の行動から、その人の性格全体を決めてしまうのは、心理学では基本的帰属錯誤と呼ばれる偏りです。1本の研究から、その分野全体を決めてしまうのも、同じような飛躍です。
1回の遅刻から「時間にルーズな人だ」と決める前に、電車の遅延や、締切の重なりといった事情を確かめるように、1本の追試の失敗から「この分野はダメだ」と決める前に、条件や方法の違いを確かめたいところです。
他人の行動を性格で説明し、状況を軽く見る傾向を、古典実験とメタ分析から整理した記事です。→ https://kitarekoi.com/fundamental-attribution-error/
なぜ再現しなかったのか
再現しなかった理由は、一つではありません。研究文化と統計の仕組みが、組み合わさっています。ここでは、4つの原因を整理します。
検出力の不足
検出力とは、効果が本当にあるときに、それを検出できる確率のことです。参加者が少ない研究では、検出力が低くなります。検出力が低いと、効果があっても有意にならないことが増えるだけでなく、有意になったとしても、効果量が過大に見積もられやすくなります。
検出力の不足は、2015年の追試以前から指摘されていました。Buttonらは、神経科学を中心に、小さなサンプルサイズが研究の信頼性を損なう仕組みを整理しています [8]。
実用的な目安として、論文を読むときに「参加者は何人か」を確かめるだけでも、読み方は変わります。参加者が20人ほどの研究と、200人ほどの研究では、同じ「有意」でも、証拠の重みが違います。参加者数が書かれていない記事は、そもそも確認のしようがありません。そのときは、「この話の根拠は、どれくらいの人数の研究なのか」と、まず問い直してみてください。
p-hackingとHARKing
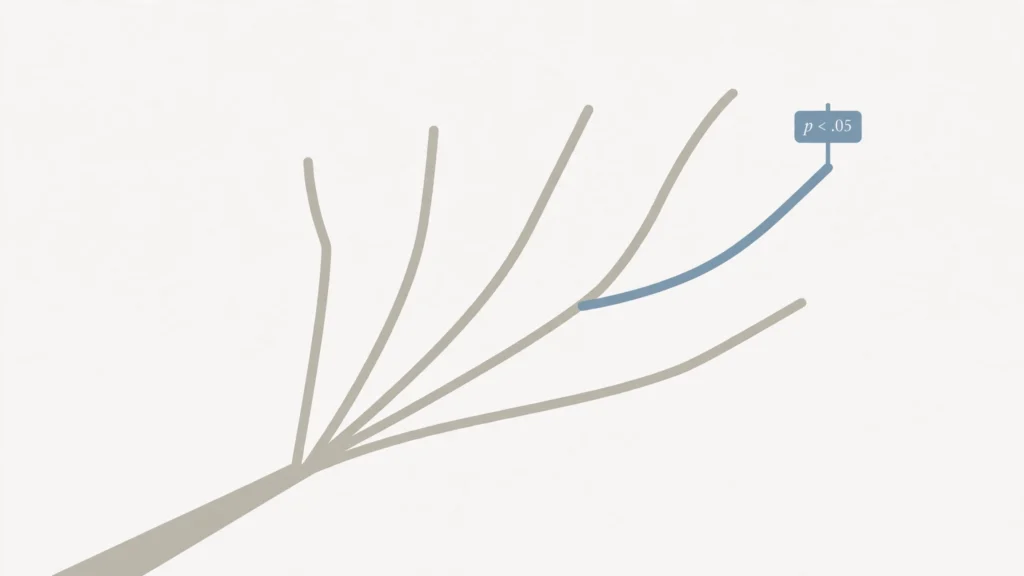
p-hackingとは、p < .05 という有意水準を下回るまで、分析方法を変え続ける行為です。結果変数を変える、外れ値を除外する、共変量を入れたり外したりする、データ収集を途中で止める、といった選択が含まれます。
HARKingとは、Hypothesizing After the Results are Known の略で、結果を見てから仮説を立て、あたかも最初から予測していたかのように提示することです。
どちらも、必ずしも意図的な不正とは限りません。「よさそうな分析を選ぶ」という、ごく普通の判断の積み重ねが、結果として有意な結果だけを残すことがあります。問題は、その選択の過程が論文に書かれていないことです。読む側は、報告された分析が「最初から決まっていたもの」なのか、「結果を見て選ばれたもの」なのかを区別できません。
研究者の自由度として、よく挙げられる選択は次の通りです [3]。
| 選択 | 例 |
|---|---|
| どの結果変数を報告するか | 2つの変数のうち、有意になった方だけを報告する |
| データ収集をいつ止めるか | 有意になった時点で収集を止める |
| 外れ値をどう扱うか | 外れ値を除外すると有意になる場合に、除外する |
| 共変量を入れるか | 共変量を入れると有意になる場合に、入れる |
こうした選択を、結果を見ながら都合のよい方向へ積み重ねると、名目上は5%のはずの偽陽性率が、60%超まで跳ね上がることが、シミュレーションで示されました [3]。
出版バイアス
学術誌は、有意で、新しく、驚くような結果を好む傾向があります。「効果がなかった」という結果の研究は、掲載されにくくなります。これを出版バイアス、あるいはファイルドロワー問題といいます。有意でない結果が、研究者の引き出しに眠ったままになる、という意味です。
出版バイアスがあると、発表された文献だけを見ると、効果があるように見える研究ばかりが集まります。発表されていない研究まで含めれば、効果はもっと小さかったかもしれない、ということです。
2016年にNatureが行った1,576人の研究者への調査では、70%超が「他者の実験の再現に失敗したことがある」と答え、半数超が「自分の実験の再現に失敗したことがある」と答えました [7]。この調査は、研究者の経験を聞いたもので、再現率そのものを測ったものではありません。ただ、再現の難しさが心理学だけの問題ではなく、多くの分野で共有されていることは示しています。
出版バイアスは、SNSの見え方とも似ています。画面に並ぶ投稿は、すべての人の意見を数えた結果ではなく、投稿した人、拡散されたもの、表示されたものだけを集めた結果です。発表された論文も同じで、すべての研究を数えた結果ではなく、掲載されたものだけを集めた結果です。「見えているものが、全体だ」と思い込むと、判断を誤ります。
新規性を評価するインセンティブ
研究者の評価は、新しい発見を出したかどうかで決まりやすい仕組みになっています。追試は、新規性が低いと見なされ、学術誌に載りにくく、評価にもつながりにくい。そうなると、「もう一度確かめる」作業そのものが、研究者のキャリアの中で後回しになります。
OSC 2015の論文も、この点を指摘しています。「革新は発見のエンジンだが、追試はその発見が確からしい道筋かどうかを示す。進歩は両方に頼っている」と [1]。
この4つは、別々の問題ではありません。検出力が低い研究が、有意な結果だけを選んで報告され、有意な結果だけが掲載され、新規性だけが評価される。そうした仕組みが重なると、発表された文献の効果量は、実際の効果より大きく見えやすくなります。
「ここまで投資したから」という気持ち
もう一つ、研究の世界にも、日常と同じ判断の癖が働くことがあります。長く取り組んできた理論や仮説に、時間や労力を注いできたほど、手放しにくくなる。恋愛で「ここまで付き合ったのに」と別れを迷う気持ちと、構造は似ています。過去に費やしたものは、すでに取り戻せません。判断するときは、過去の投資ではなく、今ある証拠と、これからの検証で考える必要があります。
もちろん、研究者の動機を外から断定することはできません。ここで言いたいのは、理論への愛着が、証拠の評価に混ざり得る、という注意点です。だからこそ、分析計画を事前に固定したり、第三者が追試したりする仕組みが、個人の気持ちとは別に必要になります。
「ここまで付き合ったのに」という気持ちを、取り戻せない過去・今も残る価値・これからの負担に分けて整理した記事です。→ https://kitarekoi.com/sunk-cost-relationship/
「ビートルズを聴くと若返る」実験
p-hackingがどれほど大きな問題になり得るかを示した、有名な研究があります。Simmons、Nelson、Simonsohnによる2011年の論文「False-Positive Psychology」です [3]。
この論文では、研究者の自由度(researcher degrees of freedom)という考え方が示されました。分析の際に研究者が選べる、ごく普通の選択肢のことです。たとえば、
- 2つの結果変数のうち、どちらを報告するか
- データ収集をいつ止めるか
- 外れ値をどう扱うか
- 共変量を入れるか、入れないか
こうした選択を、結果を見ながら都合のよい方向へ積み重ねると、名目上は5%のはずの偽陽性率が、60%超まで跳ね上がることが、シミュレーションで示されました [3]。
論文では、実例として、ビートルズの曲「When I’m Sixty-Four」を聴いた参加者は、聴かなかった参加者より、実質的に約1年半若くなった、という結果が示されました。統計的には F(1, 17) = 4.92、p = .040 でした [3]。もちろん、曲を聴いて年齢が若返ることはありません。この実験は、p-hackingを使えば、あり得ない結論でも「有意」に見せられる、という実演でした。
ここで大切なのは、この論文の結論です。著者らは、研究者を責めるのではなく、分析の自由度を事前に決めて、すべて報告する、という仕組みを提案しました。具体的には、データ収集の停止規則を決める、集めた変数をすべて報告する、条件をすべて報告する、外れ値を除外した場合は除外しない場合の結果も報告する、共変量を使った場合は使わない場合の結果も報告する、といったものです [3]。
p-hackingは、悪意のある捏造とは違います。だからこそ、個人の善意に頼るのではなく、分析計画を事前に固定する仕組みが必要だ、というのが、この論文の主張です。
反論も読む
OSC 2015の結果に対しては、強い反論も出ました。ここでは、その反論と、OSC側の応答を、両方読みます。
2016年、Gilbert、King、Pettigrew、Wilsonは、Science誌にコメントを発表し、OSCの研究には3つの統計的な誤りがあり、再現性は過小評価されていると主張しました [4]。彼らの主張は、大きく3つです。
- 追試の検出力が、原研究の効果を検出するには不十分だった場合がある
- 追試の手順が、原研究と微妙に違っていた場合がある
- そうした誤差を考慮すると、データは「ほとんどの原研究の効果は本物だった」という結論とも整合する
彼らは、Many Labsプロジェクトの結果も引き合いに出しました。Many Labsでは、36の研究室が16の研究を追試し、574件の追試を行いました。その結果から計算すると、再現率は85%になる、というのが彼らの主張でした [4]。
これに対して、OSC側は応答を発表しました [5]。OSC側の主張は、Gilbertらの計算は楽観的な仮定に依存しており、出版バイアスを仮定から外している、というものです。そして、効果量の低下という中心的な知見は、批判に対しても頑健だ、としました。
この論争は、完全には決着していません。応答論文では、「楽観的な結論も悲観的な結論も、どちらも可能であり、どちらもまだ正当化されていない」と述べられています [5]。
この「決着していない」という状態こそ、読む側にとって重要です。36%という数字を「心理学はダメだ」の証拠として使うのも、85%という数字を「心理学は大丈夫だ」の証拠として使うのも、どちらも一面的です。同じデータを見て、合理的な研究者が違う結論を出すことがある。そのこと自体が、1本の研究や1つの数字だけで判断しない理由になります。
2015年以降、何が変わったのか
再現性の危機のあと、心理学の研究文化は変わり始めました。ここでは、3つの変化を紹介します。
事前登録
事前登録とは、データを集める前に、仮説、サンプルサイズ、分析計画を公開の場に記録しておく仕組みです。これにより、結果を見てから仮説や分析を変えることが難しくなります。Open Science Framework(OSF)やAsPredictedといったプラットフォームが、事前登録を受け付けています。
事前登録は、p-hackingやHARKingを完全になくすものではありません。ただ、「最初から決まっていた分析」と「あとから選ばれた分析」を区別できるようになります。読む側は、論文に事前登録があるかどうかを確かめることで、その研究の分析がどれだけ事前に固定されていたかを見られます。
Registered Reports
Registered Reportsとは、研究の導入と方法を、結果が出る前に査読し、採択を決める出版形式です。結果が有意かどうかではなく、問いと方法の質で採択が決まるため、「効果がなかった」という結果も掲載されやすくなります。
この形式は、2012年にChambersが提案し、Cortex誌で最初に試みられました。OSC 2015の参考文献でも、Registered Reportsの方法論が挙げられています [1]。
オープンサイエンス
データ、材料、分析コードを公開する動きも広がりました。Nosekらは、2015年にScience誌で、オープンな研究文化を促進するための提言をまとめています [9]。データが公開されていれば、他の研究者が同じデータで同じ分析をやり直し、結果を確認できます。
ただし、変化はまだ途上です。事前登録やデータ共有は広がっていますが、すべての研究で行われているわけではありません。読む側としては、「この研究は事前登録されているか」「データは公開されているか」「追試はあるか」を、論文を読むときのチェック項目として使えます。
有名な効果はどうなったのか
再現性の危機のあと、よく知られた心理学の効果のいくつかは、追試で揺らぎました。たとえば、社会的プライミングの一部や、パワーポーズのホルモンへの影響などが、追試で再現されにくい例として挙げられることがあります。
ただ、ここでは個別の効果について「否定された」「証明された」と断定しません。理由は、追試の結果も、条件や方法によって変わるからです。ある追試で再現されなかったからといって、その効果があらゆる条件で存在しないとは言えません。逆に、ある追試で再現されたからといって、その効果がいつでも成り立つとも言えません。
代わりに、Many Labs 2の結果を見ます。Many Labs 2では、28の古典的・現代的な研究を、125のサンプル、15,305人の参加者、36の国と地域で、事前登録された方法で追試しました [2]。
結果は、次の通りでした。
- p < .05 の基準で、28件中15件(54%)が、原研究と同じ方向に有意な効果を示しました [2]。
- より厳しい p < .0001 の基準でも、28件中14件(50%)が有意でした [2]。
- 効果量の中央値は、原研究の Cohen’s d = 0.60 に対して、追試では d = 0.15 でした [2]。
- 28件中7件では追試の効果量が原研究より大きく、21件では小さくなりました [2]。
そして、再現された効果は、サンプルや文化が違っても、比較的一貫していました。再現されなかった効果は、どこでも再現されにくい傾向がありました [2]。つまり、「場所や文化が違ったから再現されなかった」という説明だけでは、この結果は説明しにくい、ということです。
この結果は、OSC 2015の結果と、方向性としては一致しています。約半分の効果が再現され、効果量は原研究より小さくなる。ただし、再現された効果は、比較的頑健でした。
読む側の技術――研究の強さを測る5つのレンズ
ここまでを読んで、「では、1本の研究をどう読めばいいのか」と感じた人もいるかもしれません。この記事の提案は、次の5つのレンズです。これは、研究の診断ではなく、読む側が「どこまで信じるか」を判断するための見取り図です。
- 効果量はどれくらいか:p値だけでなく、効果の大きさを見る。効果量が小さいのに、見出しだけが大きい場合は注意する。
- p値の強さはどれくらいか:p = .04 と p < .001 では、証拠の強さが違う。ぎりぎりの有意水準だけで支えられた結論は、追試で揺れやすい。
- サンプルと検出力は十分か:参加者が少ない研究では、効果量が過大に出やすい。サンプルサイズと、検出力の記載があるかを見る。
- 事前登録・追試はあるか:分析計画が事前に固定されていたか。同じ知見を別のチームが追試しているか。1本だけで終わっていないか。
- メタ分析・複数研究の一致はあるか:1本の研究ではなく、複数の研究をまとめたメタ分析や系統的レビューがあるか。複数の研究が同じ方向を向いているか。
この5つを、すべて満たす研究だけが「信じられる」という意味ではありません。5つのうち、どれが欠けているかを見ることで、「何がまだ分かっていないのか」が見えてきます。
たとえば、効果量が大きく、p値も強く、サンプルも十分で、事前登録もあり、メタ分析でも支持されている知見は、1本の研究よりずっと強い証拠です。逆に、効果量の記載がなく、p値がぎりぎりで、サンプルが少なく、追試もメタ分析もない知見は、「面白い仮説」として読むのが適切です。
この見方は、恋愛や人間関係の記事を読むときにも使えます。たとえば、マッチングアプリの研究では、サンプルの偏りや、調査対象の選び方が、結果の読み方を大きく変えます。
マッチングアプリ疲れの研究を、サンプルの偏りや調査対象の限界と一緒に整理した記事です。→ https://kitarekoi.com/matching-app-fatigue/
なじみがあるからといって、信じていいわけではない
もう一つ、読む側の注意点があります。何度も目にした話は、なじみがあるだけで、正しいように感じやすくなります。単純接触効果は、同じ刺激に繰り返し触れることで、その刺激への評価が上がることがある、という概念です。もとの研究は、言葉や記号への評価を扱ったもので、恋愛感情を直接測ったものではありません。
研究の話も同じです。何度も見出しで見た効果だからといって、証拠が強いとは限りません。「よく聞く話」と「よく確かめられた話」は、別のものです。なじみを、証拠の強さと取り違えないようにしたいところです。
単純接触効果を、会う回数と恋愛感情を混同しない形で、原著とメタ分析から整理した記事です。→ https://kitarekoi.com/mere-exposure-effect-limit-love/
実践ワーク――ニュース見出しを5つのレンズで診断する
ここからは、実際に使える練習です。以下のような見出しを目にしたら、5つのレンズを当ててみてください。見出しは架空の例です。特定の記事や研究を指すものではありません。
架空の見出し1:「〇〇をすると、幸福度が上がることが判明!」
- 効果量はどれくらいか:記事に効果量の記載はあるか。「上がった」とだけ書かれていて、どれくらい上がったのかが書かれていない場合は、注意する。
- p値の強さはどれくらいか:p = .04 なのか、p < .001 なのか。ぎりぎりの有意水準だけなら、追試で揺れやすい。
- サンプルと検出力は十分か:参加者は何人か。20人ほどの研究なら、効果量が過大に出ている可能性がある。
- 事前登録・追試はあるか:1本の研究だけで「判明」と言っていないか。追試があるか。
- メタ分析・複数研究の一致はあるか:他の研究でも同じ方向の結果が出ているか。
架空の見出し2:「科学的に証明された、モテる話し方」
- 「証明された」という言葉に注意する。1本の研究で「証明」されることは、ほとんどない。
- 効果量、サンプル、追試、メタ分析のどれが書かれているか。どれも書かれていない場合は、「面白い仮説」として読む。
- 研究の対象は誰か。大学生だけの研究なら、すべての年齢層に当てはまるとは限らない。
架空の見出し3:「心理学はもう信じられない」
- どの数字を根拠にしているか。36%だけを取り出していないか。39%、47%、68%という別の測り方も並べられているか。
- 分野による違いは書かれているか。認知心理学と社会心理学で再現率が違ったことは、触れられているか。
- 反論は書かれているか。Gilbertらの反論と、OSCの応答の両方が出ているか。
このワークの目的は、ニュースを疑うことではありません。見出しの大きさと、証拠の強さを分けて読むことです。見出しが大きくても、証拠が弱いことはあります。見出しが地味でも、証拠が強いことはあります。どちらも、5つのレンズで確かめてみてください。
よくある質問
- Q心理学はもう信じられないのですか?
- A
そうではありません。再現性の危機が示したのは、1本の論文だけで結論を出す読み方が危うい、ということです。追試やメタ分析で繰り返し確認された知見は、1本の研究よりずっと強い証拠です。心理学のすべてを信じないのではなく、証拠の強さによって信じ方を変える、というのがこの記事の提案です。
- Q36%という数字は、心理学全体の再現率ですか?
- A
いいえ。2008年に3つの主要な学術誌に掲載された100本の研究を追試したときの、特定の基準での推定値です。測り方を変えると、39%、47%、68%という数字も同じ研究から出ています。分野によっても、認知心理学で約50%、社会心理学で約25%と違いました。
- Q再現されなかった研究は、すべて間違いだったのですか?
- A
そうとは限りません。追試で有意にならなかった理由には、偶然のばらつき、参加者や手順の違い、効果が小さいことなどが含まれます。1回の追試の失敗だけで、原研究が間違いだったと決めることはできません。複数の追試やメタ分析で、同じ方向の結果が積み重なったときに、判断が固まってきます。
- Qp値とは何ですか?
- A
効果がないと仮定したときに、そのデータ以上に極端な結果が出る確率です。p < .05 は、「効果がないと仮定したときに、こうした結果が出る確率は5%未満」という意味です。p値が小さいほど、効果がないという仮定が疑わしくなります。ただし、p値は効果の大きさを表すものではありません。効果量と一緒に見る必要があります。
- Q効果量とは何ですか?
- A
効果の大きさを表す数値です。p値が「効果があるかどうか」の目安なのに対して、効果量は「効果がどれくらい大きいか」の目安です。相関係数 r や Cohen’s d などで表します。OSC 2015では、原研究の平均 r = 0.403 に対して、追試は r = 0.197 でした [1]。効果が半分ほどになった、ということです。
- Qp-hackingは、不正なのですか?
- A
必ずしも意図的な不正とは限りません。分析の選択を結果を見ながら変えることは、ごく普通の判断の積み重ねで起き得ます。問題は、その選択の過程が論文に書かれていないことです。だからこそ、分析計画を事前に固定する事前登録や、すべての分析を報告する仕組みが提案されています。
- Q事前登録とは何ですか?
- A
データを集める前に、仮説、サンプルサイズ、分析計画を公開の場に記録しておく仕組みです。結果を見てから仮説や分析を変えることが難しくなります。p-hackingやHARKingへの対策として広がっています。事前登録があるかどうかは、論文を読むときのチェック項目の一つです。
- QRegistered Reportsとは何ですか?
- A
研究の導入と方法を、結果が出る前に査読し、採択を決める出版形式です。結果が有意かどうかではなく、問いと方法の質で採択が決まるため、「効果がなかった」という結果も掲載されやすくなります。2012年に提案され、Cortex誌で最初に試みられました。
- Q一般の読者は、論文のどこを見ればいいですか?
- A
この記事で紹介した5つのレンズが目安になります。効果量、p値の強さ、サンプルと検出力、事前登録・追試の有無、メタ分析の有無です。すべてを論文で確認するのは難しい場合もあります。そのときは、追試やメタ分析があるかどうか、複数の研究が同じ方向を向いているかどうかを、まず確かめてみてください。
- QWEIRD問題とは何ですか?
- A
心理学の研究対象が、西洋(Western)、教育を受けた(Educated)、工業化された(Industrialized)、豊かな(Rich)、民主的な(Democratic)社会の人々に偏っている、という問題です。OSC 2015の追試でも、参加者の偏りは議論の対象になりました。WEIRD問題については、EVIDOGRAPHのWEIRD問題の記事で詳しく解説しています。
まとめ
心理学研究の再現性は、36%という一つの数字では語れません。
100本の追試では、原研究の97%が有意だったのに対して、追試では36%しか有意になりませんでした。効果量も、平均で半分になりました [1]。この落差は、検出力の不足、p-hackingやHARKing、出版バイアス、新規性を評価するインセンティブが重なって起きたものと考えられます。
ただ、同じ結果を別の測り方で見ると、39%、47%、68%という数字も出てきます。分野によっても、認知心理学で約50%、社会心理学で約25%と違いました。Gilbertらの反論とOSCの応答は、まだ決着していません。Many Labs 2では、28件中15件が再現され、再現された効果は比較的頑健でした [2]。
ここから言えるのは、心理学が壊れたということではありません。1本の研究を「証明」として読むのをやめ、複数の研究の積み重ねで判断する、という読み方への転換です。
論文を読むときは、「有意だったか」だけでなく、「効果はどれくらいか」「追試はあるか」「事前登録はあるか」「メタ分析はあるか」を見てみてください。その5つのレンズが、心理学の話を「信じるか、信じないか」の二択から、「どこまで、どんな条件で信じるか」という判断へ変えてくれます。
EVIDOGRAPHでは、今後も、こうした研究の読み方を、具体的な論文を起点に整理していきます。次に読むべき記事として、p-hackingの仕組みを掘り下げた記事と、心理学の研究対象の偏りを扱うWEIRD問題の記事もあわせてどうぞ。
参考文献・出典
- Open Science Collaboration「Estimating the reproducibility of psychological science」Science, 349(6251), aac4716, 2015年(最終確認:2026年11月19日)
https://www.science.org/doi/10.1126/science.aac4716 - Klein, R. A. ほか「Many Labs 2: Investigating Variation in Replicability Across Samples and Settings」Advances in Methods and Practices in Psychological Science, 1(4), 443–490, 2018年(最終確認:2026年11月19日)
https://doi.org/10.1177/2515245918810225 - Simmons, J. P., Nelson, L. D., & Simonsohn, U.「False-positive psychology: Undisclosed flexibility in data collection and analysis allows presenting anything as significant」Psychological Science, 22(11), 1359–1366, 2011年(最終確認:2026年11月19日)
https://doi.org/10.1177/0956797611417632 - Gilbert, D. T., King, G., Pettigrew, S., & Wilson, T. D.「Comment on “Estimating the reproducibility of psychological science”」Science, 351(6277), 1037, 2016年(最終確認:2026年11月19日)
https://doi.org/10.1126/science.aad7243 - Anderson, C. J. ほか「Response to Comment on “Estimating the reproducibility of psychological science”」Science, 351(6277), 1037, 2016年(最終確認:2026年11月19日)
https://doi.org/10.1126/science.aad9163 - Ioannidis, J. P. A.「Why most published research findings are false」PLOS Medicine, 2(8), e124, 2005年(最終確認:2026年11月19日)
https://doi.org/10.1371/journal.pmed.0020124 - Baker, M.「1,500 scientists lift the lid on reproducibility」Nature, 533, 452–454, 2016年(最終確認:2026年11月19日)
https://doi.org/10.1038/533452a - Button, K. S. ほか「Power failure: Why small sample size undermines the reliability of neuroscience」Nature Reviews Neuroscience, 14, 365–376, 2013年(最終確認:2026年11月19日)
https://doi.org/10.1038/nrn3475 - Nosek, B. A. ほか「Promoting an open research culture」Science, 348, 1422–1425, 2015年(最終確認:2026年11月19日)
- 池田功毅、平石界「心理学における再現可能性危機:問題の構造と解決策」心理学評論, 59(1), 2016年(最終確認:2026年11月19日)