「研究の結果、有意な差が確認されました」。
この一文を見ると、「科学的に証明された」と感じませんか。でも、その「有意」は、分析の仕方を変えれば、ありえない結論でも出てしまうことがあります。
2011年、3人の研究者は、ビートルズの曲を聴くと人が約1年半若返る、という結果を発表しました。もちろん、曲を聴いて年齢が若返ることはありません。彼らが示したかったのは、その結論そのものではなく、「有意な結果」がどれほど簡単に作れてしまうか、でした。
この記事では、p-hackingとは何か、なぜ起きるのか、どうすれば防げるのかを、その論文を起点に整理します。最後に、読む側が1本の研究のp値をどう読めばいいのか、具体的な見方も提示します。
この記事でわかること
- p-hackingとは何か。研究者の自由度との関係
- p値の正しい読み方と、検定を繰り返すと何が起きるか
- 4つの研究者の自由度で、偽陽性率が5%から約60.7%に上がる仕組み
- ビートルズ実験の詳細と、開示要件を満たした書き直し版
- HARKingと「分岐する小道の庭」
- 事前登録とRegistered Reportsによる対策
- 再現性の危機の記事で紹介した「5つのレンズ」を使った、p-hackingの見抜き方
先に結論
p-hackingとは、有意な結果(p < .05)が出るまで、データの集め方や分析の仕方を変え続けることです。
p-hackingがやっかいなのは、悪意のある捏造とは限らないことです。分析の途中で出てくる、ごく普通の選択を積み重ねるだけで起きます。どの結果変数を使うか、データをいつまで集めるか、外れ値をどう扱うか、共変量を入れるか。こうした選択は、どれもそれ自体は正当な判断です。問題は、その選択を「結果を見てから」都合のよい方向へ決め、しかもその過程を論文に書かないことです。
Simmons、Nelson、Simonsohnによる2011年の論文は、よくある4つの研究者の自由度だけで、偽陽性率が5%から約60.7%まで上がることを、シミュレーションで示しました [1]。偽陽性とは、効果がないのに「効果がある」と誤って判断することです。
ここから言えるのは、次のことです。
p値が小さいことは、それだけでは「確かな証拠」にはなりません。分析がどれだけ事前に決まっていたか、試した分析がすべて報告されているかを見なければ、p値の額面は信用できません。
用語集——この記事で使う言葉
この記事では、いくつかの専門用語を使います。ここで一度、意味をそろえておきます。
| 用語 | 意味 |
|---|---|
| p値 | 効果がないと仮定したときに、そのデータ以上に極端な結果が出る確率 |
| 帰無仮説 | 「効果がない」という仮定。p値は、この仮定のもとでの確率を表す |
| 偽陽性(第1種の過誤) | 効果がないのに、「効果がある」と誤って判断すること |
| 有意水準 | 偽陽性を許容する確率の上限。慣習的に5%(p < .05)が使われる |
| 効果量 | 効果の大きさ。p値とは別に、「どれくらい効いたか」を表す |
| 検出力 | 効果が本当にあるときに、それを正しく検出できる確率 |
| 研究者の自由度 | データ収集・分析・報告の際に、研究者が選べる選択肢のこと |
| p-hacking | 有意な結果が出るまで、分析の仕方を変え続けること |
| HARKing | 結果を見たあとで、仮説をあと付けで作り、最初から予測していたように提示すること |
| 事前登録 | データを集める前に、仮説と分析計画を公開の場に記録しておく仕組み |
| Registered Reports | 研究の問いと方法を、結果が出る前に査読し、採択を決める出版形式 |
| 出版バイアス | 有意な結果だけが発表されやすく、有意でない結果が発表されにくい偏り |
| 探索的分析 | データを見ながら仮説や分析を探る分析。新しい発見の出発点になる |
| 確証的分析 | 事前に立てた仮説を、事前に決めた方法で検証する分析 |
探索的分析と確証的分析の区別は、この記事の鍵です。探索すること自体は悪くありません。問題は、探索で見つけた結果を、確証した結果のように提示することです。p-hackingとHARKingは、どちらもこの区別をあいまいにします。
p-hackingとは
p-hackingとは、統計的に有意な結果(通常は p < .05)が得られるまで、データや分析を操作することです。データドレッジング、データフィッシング、有意性追求とも呼ばれます。
Simmonsらの論文では、p-hackingの原因を「研究者の自由度」と呼びました [1]。データの収集と分析の過程で、研究者が決めなければならない選択肢のことです。論文の要旨では、こう述べられています。
心理学の研究者は、偽陽性の割合を5%以下に抑えることを名目上は支持している。にもかかわらず、データ収集・分析・報告における柔軟性が、実際の偽陽性率を劇的に引き上げる。多くの場合、研究者は、効果が存在しないことを正しく見つけるよりも、効果が存在すると誤って見つける可能性の方が高い。
ここでいう「柔軟性」は、特別な技術ではありません。次のような、日常的な判断です。
- どの結果変数を報告するか
- データをいつまで集めるか
- 外れ値をどう扱うか
- どの条件を組み合わせ、どれを比較するか
- どの共変量を入れるか
- 測ったものを組み合わせるか、変換するか
論文は、こうした探索的な行動は「悪意の副産物ではなく、分析の決め方に関する曖昧さと、有意な結果を見つけたいという研究者の欲求の結果」だと述べています [1]。つまり、p-hackingは、悪い人がする特別な不正ではなく、普通の研究者が陥りやすい仕組みの問題です。
p値の読み方——p < .05 は何を保証するのか
p-hackingを理解するには、まずp値が何を測っているかを知る必要があります。
p値は、「効果がないと仮定したときに、そのデータ以上に極端な結果が出る確率」です。有意水準を5%に設定すると、効果が本当にない場合でも、20回に1回くらいは「有意」な結果が出てしまいます。これは、p値の定義からくる性質です。
p値が測っていないことも、同じくらい大切です。
- 効果の大きさは測っていません。p値が小さくても、効果が小さいことはあります。
- 帰無仮説が正しい確率は測っていません。p = .04 は「仮説が正しい確率が4%」という意味ではありません。
- 結果の再現性も測っていません。p値が小さい研究でも、追試で再現されないことはあります。
検定を繰り返すと、どうなるか
p-hackingの仕組みを、もっとも単純な形で見てみましょう。効果がまったくない場合に、5%の有意水準で検定を1回だけ行えば、偽陽性が出る確率は5%です。では、同じデータを少しずつ変えて、検定を20回行ったらどうなるでしょうか。
検定が互いに独立だと仮定すると、20回すべてで有意にならない確率は 0.95 の20乗で、約36%です。つまり、少なくとも1回は有意になる確率は約64%になります。20回試せば、3回に2回は「有意な結果」が出る、という計算です。
もちろん、実際の分析では検定は独立ではありません。だから、この数字をそのまま当てはめることはできません。ただ、方向性は変わりません。試す回数が増えるほど、偶然だけで「有意」が出る確率は上がります。報告されたp値は、試した回数を考慮しなければ、額面どおりの意味を持ちません。
1つの数字だけを全体に広げない、という注意は、研究以外の場面でも同じです。たとえば、ある調査で「89.1%が疲れを感じた」という数字が出たとしても、調査対象が特定の集団に偏っていれば、その数字を「利用者全体の9割」と読むことはできません。数字には、いつも分母と対象があります。
マッチングアプリ疲れの調査で、89.1%という数字を全体に広げてはいけない理由を、調査対象の偏りと一緒に整理した記事です。→ https://kitarekoi.com/matching-app-fatigue/
研究者の自由度——4つの選択で偽陽性率が60.7%になる
Simmonsらは、コンピューターシミュレーションで、4つのよくある研究者の自由度が、偽陽性率をどれだけ引き上げるかを調べました [1]。各シミュレーションは15,000回行われ、もとになる設計は、1条件あたり20人の2条件実験でした。
- 2つの結果変数のうち、どれを報告するか選ぶ:偽陽性率 9.5%
- 10人分のデータを追加で集めて、もう一度検定する:偽陽性率 7.7%
- 性別を共変量に入れるかどうかを選ぶ:偽陽性率 11.7%
- 3つの条件のうち、どれを比較するか選ぶ:偽陽性率 12.6%
- 4つすべてを組み合わせる:偽陽性率 60.7%
1つだけなら、偽陽性率は7.7%から12.6%の範囲です。名目の5%よりは高いものの、まだ大きくは外れていません。ところが、4つを組み合わせると、60.7%まで跳ね上がります。論文の本文では「驚くべき61%の偽陽性率」と表現されています [1]。
この数字の意味を、もう一度確認しておきます。60.7%は、「4つの自由度を使った研究の60.7%が間違っている」という意味ではありません。効果がまったくない場合に、シミュレーションで作ったデータを分析したとき、少なくとも1つの分析で「有意」が出てしまう割合です。実際の研究では、効果が本当にある場合もあれば、自由度を使っていない場合もあります。ただ、自由度を組み合わせるほど、p値の額面が信用できなくなる、という方向性は確かです。
論文はさらに、こうした推定は「控えめなものかもしれない」と述べています [1]。検討した自由度は4つだけで、ほかにも多くの自由度があるからです。
4つの自由度で、偽陽性率はどう変わるか
Simmonsら(2011)のシミュレーション(15,000回)。効果がまったくない場合に、少なくとも1つの分析で「有意」が出てしまう割合です。
出典:Simmons, Nelson & Simonsohn (2011), Psychological Science [1]。名目の偽陽性率は5%です。
外れ値の扱いにも、自由度がある
自由度は、分析の細部にもあります。論文では、反応時間の外れ値をどう扱うかの例が挙げられています [1]。約30本のPsychological Scienceの論文を調べたところ、「速すぎる」反応の基準は、速い方から2.5%を除く、2標準偏差より速いものを除く、100ミリ秒や150ミリ秒より速いものを除く、など、論文によって大きく違っていました。「遅すぎる」反応の基準も、同じようにばらついていました。
どの基準も、それ自体は間違っていません。ただ、基準が事前に決まっていない場合、結果を見てから「この基準なら有意になる」と選ぶことができてしまいます。外れ値の扱いは、分析の細部に見えて、p値を大きく動かす自由度です。
「ビートルズを聴くと若返る」実験
p-hackingがどれほど大きな問題になり得るかを示したのが、Simmonsらの2つの実験です [1]。どちらも、実際に行われた実験で、報告された内容は真実です。にもかかわらず、支持しているように見える仮説は、あり得ないもの(実験1)や、必然的に誤りであるもの(実験2)でした。
実験1——子どもの歌を聴くと、年を取ったように感じる
実験1では、ペンシルベニア大学の学部生30人が、対照曲「Kalimba」か、子どもの歌「Hot Potato」を聴きました。そのあと、「今、何歳だと感じますか」と聞かれました。結果は、子どもの歌を聴いた参加者の方が、年を取ったように感じました。統計的には F(1, 27) = 5.06、p = .033 でした [1]。
実験2——ビートルズを聴くと、約1年半若返る
実験2では、同じ方法で、20人の学部生がビートルズの「When I’m Sixty-Four」か、対照曲「Kalimba」を聴きました。そのあと、生年月日と父親の年齢を答えました。父親の年齢で基準年齢の違いを調整すると、ビートルズを聴いた参加者は、聴かなかった参加者より、約1年半若くなりました。調整後の平均年齢は、ビートルズ群が20.1歳、対照群が21.5歳でした。統計的には F(1, 17) = 4.92、p = .040 でした [1]。
もちろん、曲を聴いて年齢が若返ることはありません。この実験は、p-hackingを使えば、あり得ない結論でも「有意」に見せられる、という実演でした。
開示要件を満たして書き直すと、効果は消える
論文のもっとも鋭い部分は、実験2を、提案する開示要件に従って書き直した表です [1]。書き直し版では、次のことが明らかになります。
- 集めた変数は、生年月日と父親の年齢だけではありませんでした。「今、何歳だと感じるか」「食堂で食べるのをどれくらい楽しみか」「100の平方根」「コンピューターは複雑な機械だと思うか」「母親の年齢」「早割を使うか」「政治的な立場」「4人のカナダ人クォーターバックのうち、誰が賞を取ったと思うか」「過去を『良き時代』とどれくらい呼ぶか」「性別」など、多くの変数が集められていました。
- 報告されたのは、20人の参加者だけではありませんでした。「Hot Potato」を聴いた条件の参加者もいて、合計34人でした。つまり、1つの条件が報告から落とされていました。
- データ収集の終了規則は、事前に決められていませんでした。約10人ごとに有意性をのぞきながら、データを集めていました。
- 1条件あたりの参加者数は、論文が提案する「20人以上」という基準に達していませんでした。
- 父親の年齢を共変量に入れなければ、年齢の差は小さくなり、有意ではなくなりました。F(1, 18) = 1.01、p = .33 でした [1]。
書き直し版は、原報告と比べて「適切に、ほとんど出版不可能」なものになると、論文は述べています [1]。この一文が、p-hackingの問題の核心です。開示されていない自由度があるからこそ、あり得ない結論が、説得力のある論文に見えてしまうのです。
分岐する小道の庭——悪意がなくても起きる
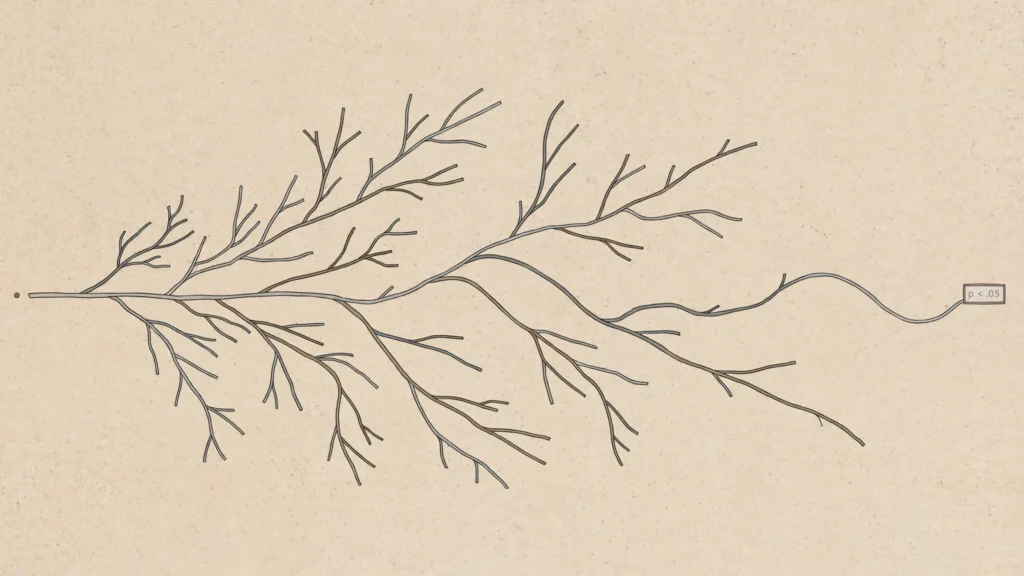
p-hackingは、意図的な操作だけではありません。GelmanとLokenは、「分岐する小道の庭」という比喩で、この点を説明しました [3]。
分析の途中で、研究者は何度も分かれ道に出会います。外れ値を除くか、変数を変換するか、どのモデルを使うか。どの道を選ぶかは、その時点で見たデータに影響されます。1つの分析だけを行ったとしても、その分析が「データを見てから選ばれたもの」であれば、実質的には複数の比較をしたのと同じことになります。
つまり、研究者が「釣り」をしているつもりがなくても、仮説を事前に立てていたとしても、データに依存した分析の選択だけで、p値は本来の意味を失います。p-hackingという言葉は、意図的な操作を連想させますが、問題の範囲はもっと広いのです。
この指摘は、p-hackingへの対策を考えるときにも大切です。「悪い研究者を取り締まる」だけでは、問題は解決しません。分析の選択を、データを見る前に固定する仕組みが必要になります。
HARKing――結果を見てから仮説を作る
p-hackingと並んで、よく挙げられるのがHARKingです。Hypothesizing After the Results are Known の略で、結果を見たあとで仮説を立て、あたかも最初から予測していたかのように提示することです。
この言葉は、Kerrが1998年の論文で作りました [2]。Kerrの定義では、HARKingとは「事後的な仮説を、研究報告の導入部分で、あたかも事前の仮説であったかのように提示すること」です。もう一つの形として、事前に立てた仮説を検証したのに、結果が支持されなかったために、その仮説を報告から落としてしまうことも含まれます。
HARKingの問題は、仮説をあとから考えること自体ではありません。データを見て、新しい仮説を思いつくことは、科学の進歩に欠かせません。問題は、その仮説が「最初から予測されていた」ものとして提示されることです。そうなると、読む側は、その仮説がデータで検証されたものなのか、データから作られたものなのかを区別できません。
HARKingには、透明な形もあります。あとから作った仮説であることを明示し、「探索的な発見」として報告するなら、それはHARKingではありません。問題になるのは、タイミングを隠すことです。
p-hackingとHARKingは、よく一緒に語られます。どちらも、分析や仮説の「順番」を書き換えることで、p値や結論の意味を変えてしまうからです。読む側としては、「この仮説は、データを集める前に立てられたものか」「この分析は、結果を見る前に決められていたものか」を、論文を読むときの問いとして持っておきたいところです。
なぜ起きるのか――3つの理由
p-hackingが起きる理由は、研究者個人の性格だけでは説明できません。仕組みが、3つ重なっています。
有意な結果が評価される
研究者の評価は、新しい発見を出したかどうかで決まりやすい仕組みになっています。有意な結果が出た論文は、学術誌に載りやすく、評価にもつながりやすい。有意でない結果は、載りにくくなります。そうなると、研究者には、有意な結果を出したいという強い動機が働きます。
Simmonsらの論文は、この動機が、分析の判断にどう入り込むかを指摘しています [1]。人は、自分の欲求に合う結論を、説得力のある理由で正当化するのが得意です。分析の決め方が曖昧であればあるほど、「有意になる選択」が「適切な選択」に見えてしまいます。
有意でない結果が発表されにくい
学術誌は、有意で、新しく、驚くような結果を好む傾向があります。「効果がなかった」という結果の研究は、掲載されにくくなります。これを出版バイアス、あるいはファイルドロワー問題といいます。有意でない結果が、研究者の引き出しに眠ったままになる、という意味です。
出版バイアスがあると、発表された文献だけを見ると、効果があるように見える研究ばかりが集まります。発表されていない研究まで含めれば、効果はもっと小さかったかもしれない、ということです。Simmonsらの論文も、開示要件だけではこの問題は解決できないと認めています [1]。すべての研究を公開のリポジトリに提出する仕組みが、長期的な拡張として提案されています。
分析の決め方が曖昧なまま
データの分析には、事前に決めておかなければならない選択が多くあります。ところが、どの選択が「正しい」かは、必ずしも明らかではありません。外れ値の基準も、共変量の入れ方も、論文によって違います。こうした曖昧さが、結果を見てから選択を決める余地を作ります。
この3つは、別々の問題ではありません。有意な結果が評価され、有意でない結果が発表されにくく、分析の決め方が曖昧なままでは、p-hackingは起きやすくなります。個人を責めるだけでは、仕組みは変わりません。
1本の論文から、その研究者の人格を決めてしまうのも、同じような飛躍です。p-hackingがあったからといって、その研究者が「不正な人だ」と決まるわけではありません。仕組みと、1回1回の判断を分けて見る必要があります。
他人の行動を性格で説明し、状況を軽く見る傾向を、古典実験とメタ分析から整理した記事です。→ https://kitarekoi.com/fundamental-attribution-error/
p-hackingと再現性の危機
p-hackingは、再現性の危機の原因の1つです。2015年に発表された大規模な追試研究では、2008年に3つの主要な学術誌に掲載された100本の研究を追試したところ、有意な結果が同じ方向で再現されたのは36%でした [4]。効果量の平均も、原研究のおよそ半分になりました。
36%という数字は、心理学全体の再現率ではありません。100本という特定のサンプルで、特定の基準を使ったときの推定値です。測り方を変えると、39%、47%、68%という数字も同じ研究から出ています。ただ、原研究の97%が有意だったのに、追試では36%しか有意にならなかった落差は、「有意な論文だけが載りやすい」という仕組みと、「効果量が過大に報告されやすい」という仕組みが組み合わさって起きたものと考えられます。p-hackingは、その仕組みの中心にあります。
再現性の危機全体については、EVIDOGRAPHの別記事で詳しく整理しています。36%という数字の読み方、分野による違い、反論と応答、2015年以降の変化までを、一本の線でつないでいます。
心理学研究の再現性はどの程度あるのか。100本の追試から考える「信じる」の基準については、EVIDOGRAPHの再現性の危機の記事で整理しています。→ https://www.kitarekoi.com/magazine/psychology-reproducibility-crisis-osc-2015/
対策――6つの開示要件と4つの査読指針
Simmonsらは、p-hackingへの対策として、研究者を責めるのではなく、開示の仕組みを提案しました [1]。著者への6つの要件と、査読者への4つの指針です。
著者への6つの要件
- データ収集の終了規則を、データを集める前に決め、論文に報告する
- 1条件あたり少なくとも20人の参加者を集める。集められない場合は、説得力のある理由を示す
- 集めた変数をすべて列挙する
- 失敗した操作を含め、すべての実験条件を報告する
- 参加者を除外した場合は、除外しない場合の結果も報告する
- 共変量を使った場合は、共変量を使わない場合の結果も報告する
この6つは、どれも「分析の自由度をなくす」ためのものではありません。自由度そのものは、研究に必要です。6つの要件が求めているのは、自由度を「開示する」ことです。どの選択をしたのか、ほかの選択ではどうなるのかを、読む側が見られるようにする。それが、p値の額面を信用できるようにする条件です。
査読者への4つの指針
- 著者が6つの要件を守っているかを確認する
- 結果の不完全さに、もっと寛容になる。完璧な結果だけを求めると、p-hackingを促してしまう
- 結果が恣意的な分析の選択に依存していないことを、著者に示させる
- データ収集や分析の正当化が説得的でない場合は、正確な追試を求める
2つ目の指針は、とくに大切です。査読者が「すべてのデータパターンが有意に予測どおりであること」を求めれば、研究者はp-hackingをせざるを得なくなります。検出力が低い研究で、完璧な結果が出ている方が、かえって疑わしい、と論文は指摘しています [1]。
この6つと4つは、2011年の提案です。いまでは、事前登録やRegistered Reportsといった、さらに強い仕組みが広がっています。ただ、Simmonsらの提案の考え方は、いまも生きています。分析の選択を「事前に決め、すべて開示する」という原則です。
事前登録とRegistered Reports
p-hackingへの対策として、いまもっとも広がっているのが、事前登録です。
事前登録とは、データを集める前に、仮説、サンプルサイズ、分析計画を公開の場に記録しておく仕組みです。これにより、結果を見てから仮説や分析を変えることが難しくなります。Open Science Framework(OSF)やAsPredictedといったプラットフォームが、事前登録を受け付けています。
Nosekらは、2015年にScience誌で、オープンな研究文化を促進するための提言をまとめています [5]。データ、材料、分析コードを公開することで、他の研究者が同じデータで同じ分析をやり直し、結果を確認できるようになります。
Registered Reportsは、事前登録をさらに進めた出版形式です。研究の導入と方法を、結果が出る前に査読し、採択を決めます。結果が有意かどうかではなく、問いと方法の質で採択が決まるため、「効果がなかった」という結果も掲載されやすくなります。
この形式は、2012年にChambersが提案し、Cortex誌で最初に試みられました [6]。Chambersは、2013年にCortex誌で、Registered Reportsの新しい出版の取り組みを紹介しています [6]。いまでは、採用する学術誌は増え続けています。
事前登録やRegistered Reportsは、p-hackingを完全になくすものではありません。ただ、「最初から決まっていた分析」と「あとから選ばれた分析」を区別できるようになります。読む側は、論文に事前登録があるかどうかを確かめることで、その研究の分析がどれだけ事前に固定されていたかを見られます。
読む側の技術――5つのレンズでp-hackingを見抜く
ここまでを読んで、「では、1本の研究のp値をどう読めばいいのか」と感じた人もいるかもしれません。再現性の危機の記事で紹介した「研究の強さを測る5つのレンズ」を、p-hackingの見抜き方に当てはめてみます。
- 効果量はどれくらいか:p値だけでなく、効果の大きさを見る。p値が小さくても、効果量が小さい場合は、実生活での意味は限られる。
- p値の強さはどれくらいか:p = .04 と p < .001 では、証拠の強さが違う。ぎりぎりの有意水準だけで支えられた結論は、p-hackingで揺れやすい。
- サンプルと検出力は十分か:参加者が少ない研究では、効果量が過大に出やすい。1条件あたり20人以上かどうかは、Simmonsらの基準でも目安になる [1]。
- 事前登録・追試はあるか:分析計画が事前に固定されていたか。同じ知見を別のチームが追試しているか。1本だけで終わっていないか。
- メタ分析・複数研究の一致はあるか:1本の研究ではなく、複数の研究をまとめたメタ分析や系統的レビューがあるか。複数の研究が同じ方向を向いているか。
この5つを、すべて満たす研究だけが「信じられる」という意味ではありません。5つのうち、どれが欠けているかを見ることで、「何がまだ分かっていないのか」が見えてきます。
とくに、p-hackingを見抜くうえで大切なのは、3番目と4番目です。サンプルが少なく、事前登録もない研究で、p値がぎりぎりの有意水準だけを示している場合は、「面白い仮説」として読むのが適切です。逆に、効果量が大きく、p値も強く、サンプルも十分で、事前登録もあり、メタ分析でも支持されている知見は、1本の研究よりずっと強い証拠です。
自分の確信をどう扱うか、という点でも、同じことが言えます。自信があることと、正しいことは別です。確信が強い人ほど、自分の判断を確かめ直す材料を持っておきたいところです。
ダニング=クルーガー効果の原研究と、その後の統計的な反論を比較し、自信・実力・自己評価のずれを整理した記事です。→ https://kitarekoi.com/dunning-kruger-confidence-self-assessment/
実践ワーク――ニュース見出しを5つのレンズで診断する
ここからは、実際に使える練習です。以下のような見出しを目にしたら、5つのレンズを当ててみてください。見出しは架空の例です。特定の記事や研究を指すものではありません。
架空の見出し1:「〇〇をすると、集中力が上がることが判明!」
- 効果量はどれくらいか:記事に効果量の記載はあるか。「上がった」とだけ書かれていて、どれくらい上がったのかが書かれていない場合は、注意する。
- p値の強さはどれくらいか:p = .04 なのか、p < .001 なのか。ぎりぎりの有意水準だけなら、p-hackingで揺れやすい。
- サンプルと検出力は十分か:参加者は何人か。1条件あたり20人未満なら、効果量が過大に出ている可能性がある。
- 事前登録・追試はあるか:1本の研究だけで「判明」と言っていないか。追試があるか。
- メタ分析・複数研究の一致はあるか:他の研究でも同じ方向の結果が出ているか。
架空の見出し2:「科学的に証明された、記憶力を高める方法」
- 「証明された」という言葉に注意する。1本の研究で「証明」されることは、ほとんどない。
- 分析の選択は開示されているか。集めた変数や条件がすべて報告されているか。報告されていない場合は、p-hackingの余地がある。
- 研究の対象は誰か。大学生だけの研究なら、すべての年齢層に当てはまるとは限らない。
架空の見出し3:「p値0.04で有意な結果が出た新研究」
- p = .04 は、ぎりぎりの有意水準です。共変量を1つ変えるだけで、有意でなくなる可能性があります。Simmonsらのビートルズ実験では、共変量を外すと p = .33 になりました [1]。
- 効果量はどれくらいか。p値だけが書かれていて、効果量が書かれていない場合は、効果の大きさが分かりません。
- ほかの分析ではどうなったか。除外した参加者を含めた場合や、共変量を使わない場合の結果も、論文に書かれているか。
このワークの目的は、ニュースを疑うことではありません。p値の大きさと、分析の透明性を分けて読むことです。p値が小さくても、分析が不透明なら、証拠は弱い。p値がぎりぎりでも、分析が透明で、追試やメタ分析があれば、証拠は強い。どちらも、5つのレンズで確かめてみてください。
よくある質問
- Qp-hackingとは何ですか?
- A
有意な結果(通常は p < .05)が出るまで、データの集め方や分析の仕方を変え続けることです。データドレッジング、データフィッシングとも呼ばれます。意図的な不正とは限らず、分析の途中で出てくるごく普通の選択を、結果を見ながら都合のよい方向へ積み重ねることで起きます。
- Qp-hackingは、不正なのですか?
- A
必ずしも意図的な不正とは限りません。分析の選択を結果を見ながら変えることは、ごく普通の判断の積み重ねで起き得ます。問題は、その選択の過程が論文に書かれていないことです。だからこそ、分析計画を事前に固定する事前登録や、すべての分析を報告する仕組みが提案されています。
- Qp値とは何ですか?
- A
効果がないと仮定したときに、そのデータ以上に極端な結果が出る確率です。p < .05 は、「効果がないと仮定したときに、こうした結果が出る確率は5%未満」という意味です。p値が小さいほど、効果がないという仮定が疑わしくなります。ただし、p値は効果の大きさを表すものではありません。効果量と一緒に見る必要があります。
- Qp = .04 と p < .001 では、どれくらい違うのですか?
- A
どちらも「有意」ですが、証拠の強さが違います。p = .04 は、ぎりぎりの有意水準です。共変量を1つ変えるだけで、有意でなくなる可能性があります。Simmonsらのビートルズ実験では、共変量を外すと p = .33 になりました [1]。p < .001 の方が、偶然だけで出る確率は低く、証拠としては強いと言えます。ただ、p値だけでは効果の大きさは分かりません。
- Q研究者の自由度とは何ですか?
- A
データ収集・分析・報告の際に、研究者が選べる選択肢のことです。どの結果変数を報告するか、データをいつまで集めるか、外れ値をどう扱うか、どの条件を比較するか、どの共変量を入れるか、といった選択が含まれます。Simmonsらは、よくある4つの自由度だけで、偽陽性率が5%から約60.7%まで上がることを示しました [1]。
- QHARKingとは何ですか?
- A
結果を見たあとで仮説を立て、あたかも最初から予測していたかのように提示することです。Kerrが1998年に作った言葉です [2]。仮説をあとから考えること自体は悪くありません。問題は、その仮説が「最初から予測されていた」ものとして提示されることです。あとから作った仮説であることを明示し、「探索的な発見」として報告するなら、HARKingではありません。
- Q事前登録とは何ですか?
- A
データを集める前に、仮説、サンプルサイズ、分析計画を公開の場に記録しておく仕組みです。結果を見てから仮説や分析を変えることが難しくなります。p-hackingやHARKingへの対策として広がっています。事前登録があるかどうかは、論文を読むときのチェック項目の一つです。
- Q一般の読者は、論文のどこを見ればいいですか?
- A
この記事で紹介した5つのレンズが目安になります。効果量、p値の強さ、サンプルと検出力、事前登録・追試の有無、メタ分析の有無です。すべてを論文で確認するのは難しい場合もあります。そのときは、p値がぎりぎりかどうか、参加者が1条件あたり20人以上かどうか、事前登録や追試があるかどうかを、まず確かめてみてください。
まとめ
p-hackingとは、有意な結果が出るまで、分析の仕方を変え続けることです。
Simmonsらの論文は、よくある4つの研究者の自由度だけで、偽陽性率が5%から約60.7%まで上がることを示しました [1]。ビートルズの曲を聴くと人が約1年半若返る、という実験は、あり得ない結論でも「有意」に見せられる、という実演でした。開示要件を満たして書き直すと、その効果は消えました。父親の年齢を共変量に入れなければ、p = .33 になったのです [1]。
p-hackingは、悪意のある捏造とは限りません。分析の途中で出てくる、ごく普通の選択を積み重ねるだけで起きます。だからこそ、個人の善意に頼るのではなく、分析計画を事前に固定し、すべての選択を開示する仕組みが必要になります。事前登録やRegistered Reportsは、その仕組みです。
論文を読むときは、「有意だったか」だけでなく、「分析は事前に決まっていたか」「試した分析はすべて報告されているか」「効果はどれくらいか」「追試やメタ分析はあるか」を見てみてください。その5つのレンズが、p値を「証明」の印から、「どこまで、どんな条件で信じるか」という判断の材料へ変えてくれます。
EVIDOGRAPHでは、今後も、こうした研究の読み方を、具体的な論文を起点に整理していきます。次に読むべき記事として、心理学の研究対象の偏りを扱うWEIRD問題の記事もあわせてどうぞ。
参考文献・出典
- Simmons, J. P., Nelson, L. D., & Simonsohn, U.「False-positive psychology: Undisclosed flexibility in data collection and analysis allows presenting anything as significant」Psychological Science, 22(11), 1359–1366, 2011年(最終確認:2026年11月19日)
https://doi.org/10.1177/0956797611417632 - Kerr, N. L.「HARKing: Hypothesizing after the results are known」Personality and Social Psychology Review, 2(3), 196–217, 1998年(最終確認:2026年11月19日)
https://doi.org/10.1207/s15327957pspr0203_4 - Gelman, A., & Loken, E.「The statistical crisis in science」American Scientist, 102(6), 460–465, 2014年(最終確認:2026年11月19日)
https://doi.org/10.1511/2014.111.460 - Open Science Collaboration「Estimating the reproducibility of psychological science」Science, 349(6251), aac4716, 2015年(最終確認:2026年11月19日)
https://www.science.org/doi/10.1126/science.aac4716 - Nosek, B. A. ほか「Promoting an open research culture」Science, 348, 1422–1425, 2015年(最終確認:2026年11月19日)
- Chambers, C. D.「Registered reports: A new publishing initiative at Cortex」Cortex, 49, 609–610, 2013年(最終確認:2026年11月19日)
https://doi.org/10.1016/j.cortex.2012.12.016